Googlebot: So arbeitet Googles Crawler und so prüfst und steuerst du ihn
Der Googlebot ist der Web-Crawler der Google Suche: Er ruft Seiten automatisch ab, damit Google sie verarbeiten und indexieren kann. Hier erfährst du, wie du echte Googlebot-Zugriffe erkennst und den Crawler steuerst, bremst oder aussperrst.
Inhalt
Was ist der Googlebot?
Der Googlebot ist der allgemeine Name für die zwei Web-Crawler, mit denen die Google Suche Webseiten abruft: einen für Smartphones und einen für Computer. Auch wer vom „Google Bot“ spricht, meint ihn. Der Abruf ist noch keine Indexierung, erst danach entscheidet Google über die Aufnahme in den Index. Wie Crawling grundsätzlich funktioniert, erklärt unser Glossar zum Crawler.
Steht „Googlebot“ in deinen Server-Logs, betrifft der Abruf nur die Google Suche. Andere Dienste wie Google Shopping oder AdSense nutzen laut Google dieselbe Crawling-Infrastruktur, aber unter eigenen Crawler-Namen. Eine Sperre für den Googlebot wirkt trotzdem breit: auf die Google Suche einschließlich Discover sowie auf Google Bilder, den Videomodus und Google News.
Googlebot für Smartphones und für Computer
Es gibt zwei Googlebot-Varianten: Der Googlebot für Smartphones simuliert einen Mobilnutzer, der Googlebot für Computer einen Desktopnutzer. Welche Variante anfragt, steht im User-Agent-Header. In der robots.txt teilen sich beide das Token Googlebot, du kannst sie also nicht einzeln sperren.
Weil Google bei den meisten Websites vorrangig die mobile Version indexiert, stammt der Großteil der Anfragen vom Smartphone-Crawler. Für diese Mobile-First-Indexierung gilt: Die mobile Version muss denselben Hauptinhalt und dieselben robots-Meta-Tags wie die Desktopversion bieten. Und Hauptinhalte dürfen nicht erst nach Wischen, Klicken oder Tippen nachladen, denn solche Inhalte lädt Google nicht. Welche Variante eine URL zuletzt gecrawlt hat, zeigt die URL-Prüfung der Search Console im Feld „Gecrawlt über“.
Warum der Googlebot für SEO zählt
Ohne erfolgreichen Abruf durch den Googlebot kann Google den Inhalt einer Seite weder indexieren noch einer Suchanfrage zuordnen. Eine per robots.txt gesperrte URL erscheint dann zwar unter Umständen trotzdem, aber ohne Beschreibung, weil Google den Inhalt nicht kennt. Auch nach der Aufnahme bleibt der Googlebot wichtig. Er ruft bekannte Seiten erneut ab, damit geänderte Texte, Preise oder Verfügbarkeiten in der Suche ankommen. Neue Seiten findet er über interne Links und die Sitemap; für einzelne wichtige URLs kannst du in der URL-Prüfung die Indexierung beantragen. Beschäftige ihn deshalb nicht mit unwichtigen URLs wie endlosen Filterkombinationen.
Welche Google-Crawler es außer dem Googlebot gibt
Neben dem Googlebot betreibt Google unter anderem Googlebot-Image, Googlebot-Video, Googlebot-News, Storebot-Google, Google-InspectionTool, GoogleOther und AdsBot, verteilt auf drei Kategorien. Gängige Crawler wie der Googlebot halten sich beim automatischen Crawling immer an die robots.txt. Sonderfall-Crawler arbeiten auf Grundlage einer Vereinbarung mit der Website. AdsBot ignoriert zum Beispiel die allgemeine Gruppe *, du musst ihn also namentlich ansprechen. Vom Nutzer ausgelöste Fetcher wie der Google Site Verifier ignorieren die robots.txt meist, weil ein Mensch den Abruf anstößt.
Seitlich scrollen, um alle Spalten zu sehen.
| Crawler und Token | Wirkung einer Regel |
|---|---|
Googlebot | Google Suche inklusive Discover, Google Bilder, Videomodus und Google News |
Googlebot-Image | Google Bilder und Suchfunktionen mit Bildern, Logos und Favicons |
Googlebot-Video | videobezogene Suchfunktionen |
Googlebot-News | Google News; ohne eigenen User-Agent-String |
Storebot-Google | Google Shopping |
Google-InspectionTool | Testtools wie die URL-Prüfung; keine Wirkung auf die Suche |
GoogleOther (auch -Image, -Video) | kein bestimmtes Produkt, etwa interne Forschung |
Google-CloudVertexBot | von Websiteinhabern angeforderte Crawls für Vertex-AI-Agents |
Google-Extended | nur ein Token für die Nutzung in Gemini; kein Einfluss auf die Suche |
Manche Crawler hören auf zwei Tokens, und für eine Regel genügt eine Übereinstimmung. Eine Gruppe für Googlebot gilt deshalb auch für Googlebot-Image, solange es keine eigene Gruppe für Googlebot-Image gibt. Die User-Agent-Strings der Smartphone- und der Computer-Variante enthalten einen Platzhalter für die Chrome-Version:
Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/W.X.Y.Z Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Googlebot/2.1; +http://www.google.com/bot.html) Chrome/W.X.Y.Z Safari/537.36
Weil diese Versionsnummer mit neuen Chromium-Releases steigt, setze beim Filtern von Logs oder Serverregeln einen Platzhalter dafür ein.
Crawler anderer Suchmaschinen
Andere Suchmaschinen schicken eigene Crawler, für die deine Googlebot-Regeln nicht gelten: Bing vor allem den Bingbot, DuckDuckGo den DuckDuckBot und Yandex den YandexBot. Bing nennt daneben AdIdxBot, BingPreview, MicrosoftPreview und BingVideoPreview, prüft Echtheit mit dem Werkzeug „Verify Bingbot“ und regelt die Crawl-Frequenz in den Bing Webmaster Tools. DuckDuckGo veröffentlicht die IP-Adressen seines Crawlers in der Liste duckduckbot.json. Yandex empfiehlt dieselbe Doppelprüfung wie Google: Reverse-DNS auf yandex.ru, yandex.net oder yandex.com, danach Forward-DNS zurück zur IP.
Echten Googlebot erkennen und Fake-Bots aussortieren
Ob ein Zugriff wirklich vom Googlebot stammt, erkennst du zuverlässig nur an seiner IP-Adresse: per Reverse- und Forward-DNS-Lookup oder per Abgleich mit Googles IP-Listen. Den User-Agent fälschen andere Crawler laut Google oft. Prüfe deshalb die Echtheit, bevor du einen auffälligen „Googlebot“ sperrst, sonst kann die Sperre den echten Crawler treffen.
Manuell prüfen: Reverse- und Forward-DNS
Manuell prüfst du einen einzelnen Zugriff mit zwei DNS-Abfragen über den Befehl host. Löse die IP-Adresse aus deinem Log per Reverse-DNS in einen Hostnamen auf und prüfe, ob er auf googlebot.com, google.com oder googleusercontent.com endet. Löse diesen Hostnamen dann per Forward-DNS wieder auf. Nur wenn dabei dieselbe IP-Adresse herauskommt, ist der Zugriff echt, denn ein passender Hostname allein kann gefälscht sein. So sieht Googles Beispiel aus:
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1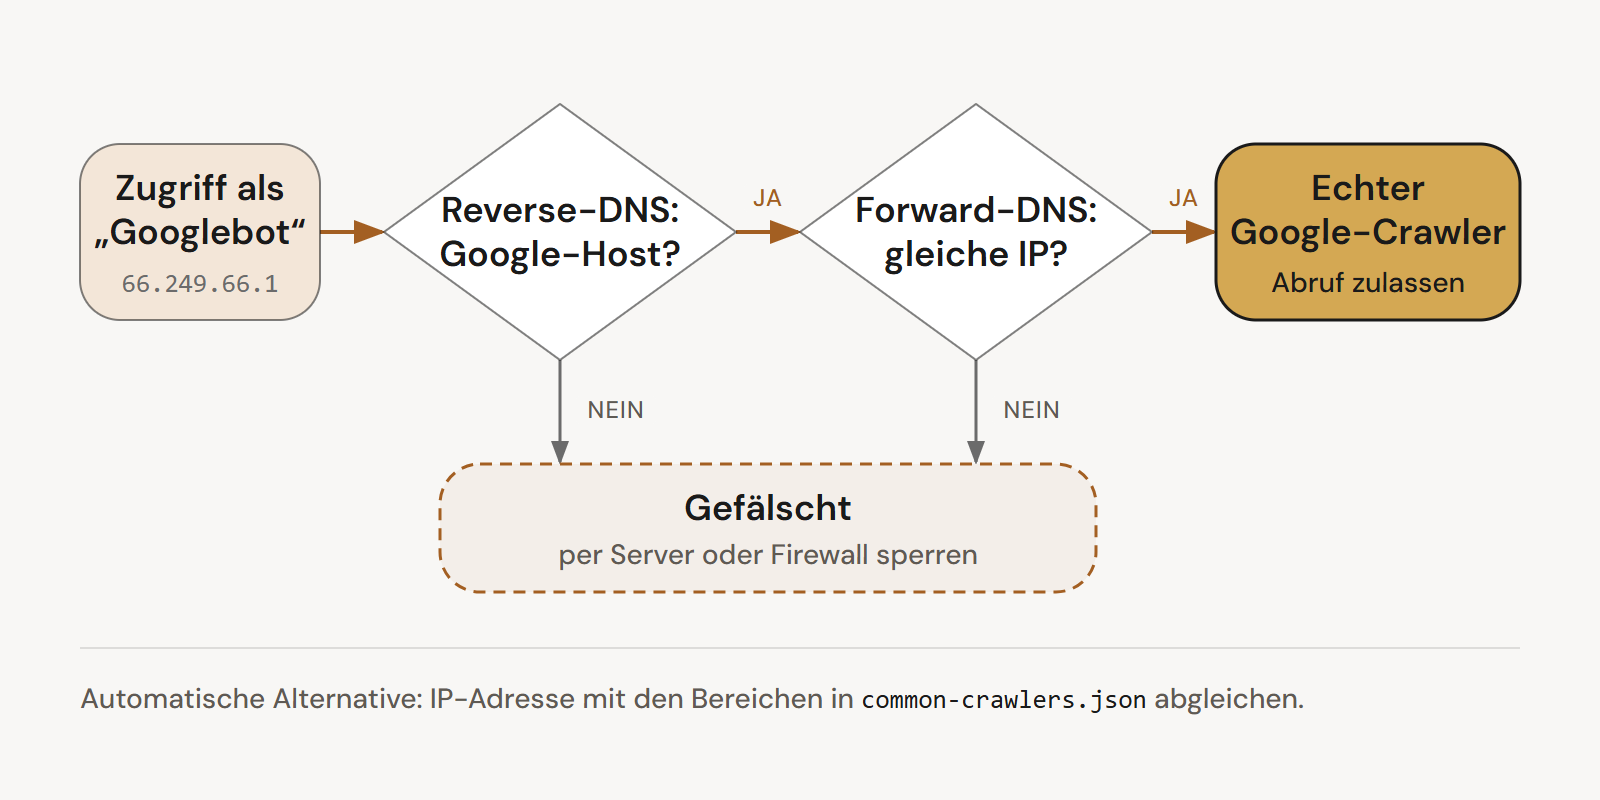
Seitlich scrollen, um alle Spalten zu sehen.
| Kategorie | Hostname nach Reverse-DNS | IP-Liste |
|---|---|---|
| Gängige Crawler wie der Googlebot | crawl-***-***-***-***.googlebot.com oder geo-crawl-***-***-***-***.geo.googlebot.com | common-crawlers.json |
| Sonderfall-Crawler wie AdsBot | rate-limited-proxy-***-***-***-***.google.com | special-crawlers.json |
| Vom Nutzer ausgelöste Fetcher | ***-***-***-***.gae.googleusercontent.com oder google-proxy-***-***-***-***.google.com | user-triggered-fetchers.json, user-triggered-fetchers-google.json, user-triggered-agents.json |
Ein echter Googlebot führt also in der Regel zu einem Hostnamen auf googlebot.com, die anderen Domains gehören zu weiteren Google-Crawlern und -Fetchern.
Automatisch prüfen: IP-Listen abgleichen
Bei vielen Zugriffen gleichst du die IP-Adressen automatisch mit Googles JSON-Listen ab, die IP-Bereiche im CIDR-Format enthalten. Für den Googlebot ist common-crawlers.json maßgeblich, für sonstige Google-Adressen wie Apps Script die allgemeine Liste goog.json. Die ältere Adresse googlebot.json leitet inzwischen auf common-crawlers.json weiter, geprüft am 04.11.2026. Jede Datei trägt einen Zeitstempel creationTime. Lade die Listen deshalb automatisch nach, statt eine Kopie fest in Firewall-Regeln zu schreiben.
Als gefälscht erkannte Bots sperrst du per Server oder Firewall anhand ihrer IP-Adresse, denn an die robots.txt halten sich nur seriöse Crawler. Gib geschützte Bereiche außerdem nie per User-Agent für „Googlebot“ frei. Laut Search-Console-Hilfe unterläuft das den Schutz, weil sich jeder als Googlebot ausgeben kann.
Wenn der echte Googlebot ausgesperrt ist
Sperrt eine Firewall, ein CDN oder ein Sicherheits-Plugin versehentlich den echten Googlebot aus, zeigt die Search Console das im Hoststatus der Crawling-Statistik und im Feld „Seitenabruf“ der URL-Prüfung. Mögliche Auslöser sind Filter nach User-Agent, eine zu strenge Ratenbegrenzung oder eine Ländersperre, denn Google crawlt überwiegend von US-IP-Adressen aus. Gib echte Google-Crawler über die IP-Bereiche aus common-crawlers.json frei. Weil der Live-Test der URL-Prüfung als Google-InspectionTool abruft, nicht als Googlebot, kontrolliere nach einer neuen Sicherheitsregel auch die Crawling-Statistik.
Googlebot sperren oder steuern: welche Methode für welches Ziel
Welche Methode passt, hängt vom Ziel ab: Das Crawling verhinderst du mit der robots.txt, die Aufnahme in den Index mit noindex und jeden Zugriff mit einem Passwortschutz. Wer die Mittel verwechselt, erreicht leicht das Gegenteil. Sperrt die robots.txt eine Seite, sieht der Googlebot ihr noindex nie.
Seitlich scrollen, um alle Spalten zu sehen.
| Ziel | Methode | Wirkung und typischer Fehler |
|---|---|---|
| Bereich nicht crawlen lassen | disallow in der Gruppe user-agent: Googlebot | Kein Abruf, die URL kann aber ohne Beschreibung erscheinen. Fehler: robots.txt als Indexsperre nutzen. |
| Seite aus den Suchergebnissen nehmen | noindex als Meta-Tag oder X-Robots-Tag-Header | Google entfernt die Seite nach dem nächsten Crawl. Fehler: die Seite zusätzlich per robots.txt sperren. |
| Inhalt nur für Berechtigte | Passwortschutz oder Login | Weder Unbefugte noch Crawler sehen den Inhalt. Fehler: Ausnahme per User-Agent für „Googlebot“. |
| Nur ein Google-Produkt steuern | eigenes Token wie Googlebot-Image | Betrifft nur dieses Produkt. Fehler: gleich den ganzen Googlebot sperren. |
| Inhalte nicht für Gemini freigeben | Google-Extended in der robots.txt | Kein Einfluss auf die Google Suche. Fehler: stattdessen den Googlebot sperren. |
Beispiele für bewusst ausgeschlossene Seiten: Einen Adminbereich schützt ein Login, eine Danke-Seite nach einem Formular hält ein noindex aus den Ergebnissen, und endlose interne Suchergebnisse sperrst du per robots.txt für das Crawling.
Für eigene Googlebot-Regeln ist eine Feinheit wichtig: Jeder Google-Crawler befolgt nur die Gruppe mit dem am besten passenden User-Agent. Legst du eine Gruppe für Googlebot an, gelten die Regeln unter user-agent: * für ihn nicht mehr. Auch Meta-Regeln lassen sich gezielt an Google richten, etwa mit <meta name="googlebot" content="noindex">. Das Link-Attribut nofollow ist dagegen keine Zugriffssperre: Findet der Googlebot die URL auf anderem Weg, kann er sie abrufen. Für interne Bereiche empfiehlt Google die robots.txt.
Google-Extended ist kein Crawler, sondern ein Token für die Nutzung deiner Inhalte beim Training und bei Antworten von Gemini. Laut Google-Doku vom 03.11.2026 will Google ab Anfang 2027 zusätzlich das Signal AIPREF mit user-agent: __usage_ai-training unterstützen.
So arbeitet der Googlebot
Der Googlebot arbeitet eine Warteschlange von URLs ab, die er vor allem über Links auf bereits gecrawlten Seiten und ergänzend über Sitemaps findet. Vor jedem Abruf prüft er die robots.txt und lässt gesperrte URLs aus. Aus der geladenen Seite liest er die Links in href-Attributen und reiht neue URLs ein. CSS- und JavaScript-Dateien ruft er separat ab. Seiten mit Statuscode 200 gehen danach ins Rendering und in die Indexierung, bekannte URLs besucht er später erneut. Eine Seite ohne Links bleibt trotzdem nicht geheim, denn ihre Adresse kann laut Google etwa über den Referrer in fremden Protokollen landen.
Was du technisch über die Zugriffe wissen solltest
Der Googlebot greift von wechselnden, überwiegend US-amerikanischen IP-Adressen zu, weil Googles Crawler verteilt auf Tausenden Maschinen in Rechenzentren weltweit laufen. Diese Merkmale siehst du in Logs und Serverkonfiguration:
Seitlich scrollen, um alle Spalten zu sehen.
| Merkmal | Angabe von Google | Was das für dich heißt |
|---|---|---|
| Herkunft | überwiegend US-IP-Adressen, bei blockierten US-Anfragen auch andere Länder | Ländersperren können ihn treffen. |
| Zeitzone | Pacific Time bei US-IP-Adressen | Zeitabhängige Inhalte sieht er mit US-Westküstenzeit. |
| Protokoll | HTTP/1.1 als Standard, HTTP/2 möglich, ohne Rankingvorteil | HTTP/2 spart Ressourcen; abschalten per Statuscode 421. |
| Komprimierung | gzip, deflate und Brotli | Komprimierte Auslieferung funktioniert. |
| Caching | ETag und Last-Modified beim erneuten Crawlen; Google empfiehlt ETag | Mit 304 auf unveränderte Seiten antworten schont den Server. |
Abruflimit: Was nach 2 MB passiert
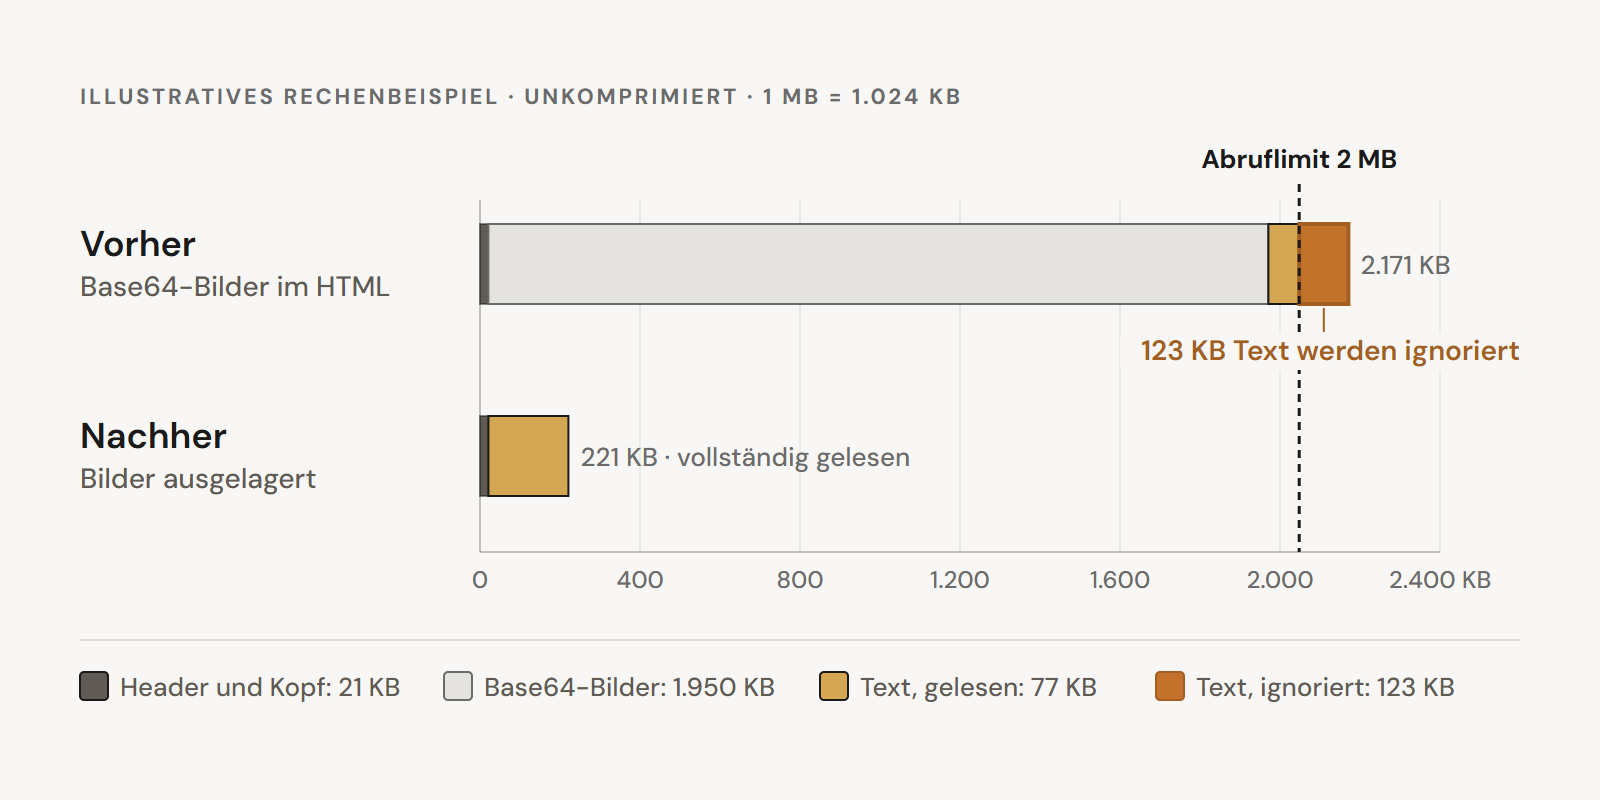
Für die Google Suche ruft der Googlebot nur die ersten 2 MB einer HTML-Datei oder eines anderen unterstützten Dateityps ab, bei PDFs die ersten 64 MB. Alles dahinter wird weder abgerufen noch gerendert noch indexiert. Das Limit gilt für die unkomprimierten Daten und schließt laut Googles Blogbeitrag, Fassung vom 29.10.2026, die HTTP-Antwortheader ein. Jede eingebundene CSS- oder JavaScript-Datei hat einen eigenen Zähler. Andere Google-Crawler ohne eigenes Limit lesen standardmäßig 15 MB, Bild- und Video-Crawler haben eigene Grenzen.
Für die meisten Seiten sind 2 MB HTML viel. Knapp wird es mit Base64-codierten Bildern, großen Inline-CSS- oder JavaScript-Blöcken oder sehr umfangreichen Menüs im HTML. Lagere solche Blöcke aus und setze Title, Meta-Tags, Canonical und wichtige strukturierte Daten weit oben ins HTML.
Rendering: Wie der Googlebot JavaScript ausführt
Der Googlebot führt JavaScript aus, allerdings zeitversetzt in einem eigenen Rendering-Schritt mit einer aktuellen Chromium-Version. Google verarbeitet Seiten in drei Phasen: Crawling, Rendering und Indexierung. Seiten mit Statuscode 200 und ohne noindex warten dafür einige Sekunden oder länger in einer Warteschlange. Im Web Rendering Service werden JavaScript und CSS geladen und XHR-Anfragen verarbeitet; Bilder oder Videos fordert er nicht an. Er arbeitet zustandslos, also ohne Sitzung oder Local Storage zwischen zwei Anfragen.
Daraus folgen drei Fallen: Per robots.txt gesperrtes JavaScript wird nicht ausgeführt, Inhalte nach Klick oder Wischen sieht Google nicht, und was eine bestehende Sitzung braucht, fehlt. Ob Google deine Inhalte sieht, zeigt der Live-Test der URL-Prüfung mit Screenshot und geladenen Ressourcen. Serverseitiges Rendering oder Pre-Rendering hilft zusätzlich, weil nicht jeder Bot JavaScript ausführt.
Wie oft kommt der Googlebot?
Im Durchschnitt greift der Googlebot laut Google meist nur etwa einmal alle paar Sekunden auf eine Website zu, kurzzeitig kann es häufiger wirken. Einen festen Rhythmus gibt es nicht. Die Menge hängt von der Kapazität deines Servers und vom Bedarf ab: Antwortet der Server schnell und fehlerfrei, nutzt Google mehr Verbindungen, bei Verzögerungen, 5xx-Fehlern oder 429 weniger. Beliebte und oft aktualisierte URLs crawlt Google häufiger, selten aktualisierte oder schwache seltener, und ein Websiteumzug erhöht den Bedarf vorübergehend.
Normalerweise bleibt die Frequenz über ein bis zwei Wochen relativ stabil. Erhöhen lässt sie sich nicht, auch nicht per Antrag. Du kannst aber die Sitemap aktuell halten, keine wichtigen Bereiche sperren und unnötige URLs vermeiden.
Googlebot bremsen, wenn der Server überlastet ist
Bei akuter Überlastung gibst du dem Googlebot kurzzeitig die Statuscodes 500, 503 oder 429 statt 200 zurück; Google senkt dann die Crawling-Frequenz für den gesamten Hostnamen. Die Notbremse hat Nebenwirkungen: Google entdeckt weniger neue Seiten, aktualisiert bestehende seltener, und entfernte Seiten bleiben unter Umständen länger im Index. Gehe so vor:
- Ursache finden. Häufige Auslöser sind laut Google Filter- und Sortierfunktionen, Kalender mit vielen Datums-URLs und Ziele dynamischer Suchanzeigen. Logs und der Googlebot-Typ in der Crawling-Statistik zeigen, ob etwa AdsBot statt des Googlebots die Last erzeugt.
- Fehlercode setzen. Bei 503 und 429 kannst du mit dem Header
Retry-Afterangeben, nach wie vielen Sekunden oder ab welchem UTC-Zeitpunkt Google es erneut versuchen soll. - Kurz halten. Googles Anleitung zum Verringern der Crawling-Frequenz (Stand 09.10.2026) nennt höchstens ein bis zwei Tage, die Search-Console-Hilfe zwei bis drei Tage. Halte dich an die kürzere Angabe, denn bei mehrtägigen Fehlercodes kann Google URLs aus dem Index entfernen.
- Zurücknehmen. Sinkt die Zahl der Fehler, erhöht Google die Frequenz automatisch wieder.
Eine robots.txt-Sperre für den verursachenden Crawler wirkt laut Search-Console-Hilfe erst nach bis zu einem Tag. Kann deine Infrastruktur keine Fehlercodes ausliefern, meldest du die zu hohe Frequenz mit einer speziellen Anfrage an Google. Ungeeignet sind die Statuscodes 401 und 403, denn sie bremsen das Crawling nicht.
Crawl-Budget: für wen es zählt
Ein knappes Crawl-Budget betrifft laut Google vor allem Websites mit mehr als einer Million Seiten und wöchentlichen Änderungen sowie Websites mit mehr als 10.000 Seiten und täglichen Änderungen. Die Zahlen sind laut Google nur grobe Orientierung. Das Budget ergibt sich aus dem Crawling-Kapazitätslimit, also dem, was dein Server verträgt, und dem Crawling-Bedarf. Kleineren Websites genügen laut Google eine aktuelle Sitemap und ein regelmäßiger Blick in den Bericht zur Seitenindexierung. Wie du verschwendetes Budget erkennst, erklärt unser Glossarartikel zum Crawl-Budget.
Googlebot-Besuche prüfen: Search Console und Server-Logs
Wann der Googlebot eine einzelne URL zuletzt abgerufen hat, zeigt die URL-Prüfung der Search Console. Das Crawling der gesamten Website zeigt der Bericht „Crawling-Statistik“, jeden einzelnen Abruf nur dein Server-Log.
Seitlich scrollen, um alle Spalten zu sehen.
| Quelle | Was du dort siehst | Grenze |
|---|---|---|
| URL-Prüfung | „Letztes Crawling“, „Gecrawlt über“, „Crawling erlaubt?“, „Seitenabruf“, „Indexierung zulässig?“; der Live-Test ruft die URL sofort ab und zeigt die gerenderte Seite | eine URL je Prüfung; ein positiver Live-Test garantiert keine Indexierung |
| Crawling-Statistik | Anfragen, Downloadgröße, Reaktionszeit, Hoststatus (robots.txt-Abruf, DNS, Serververbindung), Antworten, Dateitypen, Zweck (Erkennung oder Aktualisierung), Googlebot-Typ | nur Properties auf Stammebene; Zahlen können leicht von Logs abweichen |
| Server-Log | jeder Abruf mit IP-Adresse, Zeit, URL, Statuscode und User-Agent | User-Agent fälschbar, IP-Prüfung nötig |
Die Crawling-Statistik liegt in den Einstellungen der Property; für Websites unter 1.000 Seiten hält Google sie für wahrscheinlich entbehrlich. Zeigt sie deutlich mehr Abrufe als deine Logs, kann eine länger nicht erreichbare robots.txt dahinterstecken, denn Google zählt ausgefallene Abrufe mit. Crawling-Fehler findest du dort in der Tabelle der Crawling-Antworten.
Nur im Server-Log siehst du, welche URLs der Googlebot tatsächlich abruft, wie oft er wiederkommt und welche Statuscodes er erhält. Wie du Logs exportierst und auswertest, zeigt unser Glossarartikel zur Logfile-Analyse.
Damit ein Einbruch beim Crawling nicht erst auffällt, wenn Rankings fehlen, gehören Crawling-Statistik und Logs in die regelmäßige Kontrolle. In unserer laufenden SEO-Betreuung zählen Erreichbarkeit, Crawling und Indexierung zur technischen Arbeit.
Checkliste: So bleibt deine Website für den Googlebot erreichbar
Fünf Prüfpunkte halten deine Website für den Googlebot erreichbar: robots.txt, Sitemap, noindex und nofollow, interne Links und ein technischer Audit. Prüfe sie nach jedem Relaunch, Plugin-Update, Hosterwechsel oder einer neuen Firewall-Regel. Zeigt die Prüfung Baustellen, setzt unsere SEO-Optimierung die Korrekturen um und prüft Crawling und Indexierung nach dem Release erneut.
robots.txt prüfen und erreichbar halten
Deine robots.txt darf weder Bereiche sperren, die ranken sollen, noch CSS- oder JavaScript-Dateien, die Google zum Rendern braucht. Ob eine URL gesperrt ist, zeigt das Feld „Crawling erlaubt?“ der URL-Prüfung. Außerdem muss die Datei erreichbar sein. Als Erfolg gelten 200, auch bei leerer Datei, sowie 403, 404 und 410; bei diesen 4xx-Codes crawlt Google ohne Einschränkungen. Bei 429 oder 5xx crawlt Google die Website 12 Stunden lang nicht und nutzt danach bis zu 30 Tage die letzte gute Version. Danach crawlt Google ohne Einschränkungen, wenn die Startseite erreichbar ist, sonst gar nicht. Google speichert die Datei meist bis zu 24 Stunden zwischen und ignoriert alles jenseits von 500 KiB.
Sitemap einreichen
Eine XML-Sitemap hilft dem Googlebot, URLs zu finden, vor allem auf großen, neuen oder schwach verlinkten Websites und bei vielen Bildern, Videos oder News-Artikeln. Reiche sie im Search-Console-Bericht „Sitemaps“ ein oder nenne ihre vollständige URL in einer sitemap:-Zeile der robots.txt. Kleine, gut verlinkte Websites mit etwa 500 oder weniger relevanten Seiten brauchen laut Google unter Umständen keine. Dass alle Einträge gecrawlt und indexiert werden, garantiert sie nicht.
noindex und nofollow nur dort, wo sie gewollt sind
Seiten, die ranken sollen, dürfen kein noindex tragen, weder im Meta-Tag noch im HTTP-Header. Schon eine falsche Sucheinstellung im CMS oder ein aus der Testumgebung übernommenes noindex hält eine Seite aus dem Index. Das Feld „Indexierung zulässig?“ der URL-Prüfung zeigt, ob Google ein Verbot gefunden hat. Ist die Seite per robots.txt gesperrt, steht dort allerdings immer „Ja“, weil Google das noindex nicht lesen kann. Ein nofollow im robots-Meta-Tag setzt du nur, wenn Google den Links der Seite wirklich nicht folgen soll; auf der mobilen Version verhindert es sonst, dass Google die Bilder crawlt.
Neue Seiten intern verlinken
Verlinke jede neue Seite von mindestens einer bereits gecrawlten Seite aus, denn der Googlebot findet neue URLs vor allem über Links. Verwende dafür <a>-Elemente mit href-Attribut, denn Links in anderen Formaten liest Google meist nicht aus. Seiten ohne interne Links findet er nur über Sitemaps oder externe Verweise.
Crawling-Probleme mit einem technischen Audit finden
Systematisch findest du Crawling- und Indexierungsprobleme, indem du deine Website mit einem Crawling-Tool durchläufst und das Ergebnis mit Search-Console-Daten und Server-Logs abgleichst. Der Crawl zeigt Statuscodes, Weiterleitungsketten, noindex- und nofollow-Angaben sowie Seiten ohne interne Links; Search Console und Logs zeigen, was Google tatsächlich gesehen und abgerufen hat. Wiederhole die Prüfung regelmäßig und nach größeren Änderungen. Ein technischer SEO-Audit bündelt diese Quellen und leitet daraus priorisierte Maßnahmen ab.
Häufige Fragen zum Googlebot
Wie vielen Weiterleitungen folgt der Googlebot?
Der Googlebot folgt beim Crawlen allgemeiner Webinhalte in der Regel bis zu zehn Weiterleitungen hintereinander. Für Crawler anderer Google-Produkte können andere Grenzen gelten. Lange Weiterleitungsketten wirken sich laut Google negativ auf das Crawling aus. Leite deshalb möglichst direkt auf das endgültige Ziel weiter, statt mehrere Weiterleitungen aneinanderzuhängen.
Gilt die Crawling-Frequenz für die ganze Domain oder je Subdomain?
Google plant das Crawling je Hostname, also für jede Subdomain getrennt. Eine Subdomain wie shop.example.com gilt als eigene Website mit eigenem Crawl-Budget. Auch die robots.txt wirkt nur für den Host, das Protokoll und den Port, unter denen sie liegt. Jede Subdomain braucht deshalb ihre eigene Datei.
Darf die robots.txt für den Googlebot anders aussehen als für Besucher?
Nein. Laut Search-Console-Hilfe darf die robots.txt nicht je nach User-Agent variieren, und Cloaking ist für diese Datei nicht erlaubt. Unterschiedliche Regeln für verschiedene Crawler legst du stattdessen in getrennten Gruppen derselben Datei fest, jeweils mit eigener user-agent-Zeile.
Warum ruft der Googlebot Seiten ab, die es nicht mehr gibt?
Google vergisst eine einmal bekannte URL nicht und prüft sie deshalb gelegentlich erneut. Liefert sie den Statuscode 404 oder 410, ist das ein starkes Signal, sie nicht noch einmal zu crawlen, und die Crawling-Frequenz sinkt allmählich. Per robots.txt gesperrte URLs bleiben dagegen lange in der Crawling-Warteschlange und werden wieder gecrawlt, sobald du die Sperre aufhebst.
Bereit für mehr Rankings?
Wissen ist der erste Schritt — professionelle Umsetzung der zweite.
Verwandte Artikel
Logfile-Analyse — Server-Logfiles für SEO auswerten
Was Googlebot wirklich crawlt, verrät kein anderes Tool so genau wie deine Server-Logfiles. Wie du Logfile-Analyse richtig für SEO einsetzt, liest du hier.
Was ist ein Crawler? Crawling und Indexierung einfach erklärt
Web-Crawler entdecken, lesen und bewerten Seiten nicht auf dieselbe Weise. Hier erfährst du, wie Googlebot URLs findet und was du praktisch beeinflussen kannst.
Crawl-Budget: Definition, Komponenten und Optimierung
Das Crawl-Budget legt fest, wie viele Seiten Googlebot in einem Zeitraum crawlt. Erfahre, welche Faktoren es beeinflussen und wie du es gezielt optimierst.